手把手:30 分钟自查景区在豆包、DeepSeek、ChatGPT 里的真实形象
30 分钟 AI 可见性自查是什么:一套不需要服务器权限、不需要懂代码的免费诊断方法——用 20 个游客真实问法,在豆包、DeepSeek、Kimi、ChatGPT 里逐个提问,记录你的景区是否被提及、排第几、信息有没有错、官网有没有被引用,然后按结果分三类排出修复顺序。输出的记录表直接变成后续优化的清单。
一、引入:在花钱做 GEO 之前,先看清 AI 眼里的你
2026 年,AI 已经是旅游决策的常规入口。QuestMobile 数据显示,2026 年 9 月 AI 原生 App 月活规模达 5.46 亿,同比增长 82.1%,月人均使用次数 88.2 次;豆包 4.19 亿、DeepSeek 1.23 亿[1]。在线旅游人群中用 AI 原生 App 的占比达 69.4%[2]。
这意味着"AI 搜不到我的景区"正在从技术问题变成营收问题。2026 年上半年国内居民出游 34.63 亿人次,同比增长 5.4%,出游总花费 3.21 万亿元,同比增长 2.0%[3]。人次在涨,花费涨得更慢——"能被搜到"和"能被信任"是两件必须分别解决的事。
但在动手投入之前,先有一个更基本的问题:AI 现在到底怎么介绍我的景区?
二、用户场景:谁来做这件事,什么时候做
这套自查适合三类岗位:景区市场部与品牌岗、酒店前厅与电商负责人、文旅集团的数字营销岗。判断标准很简单——能打开豆包、DeepSeek、Kimi、ChatGPT 并提问,就可以做。准备一张空表格和 20 个问法就够了。
有两个时机特别适合做:年度规划启动时作为现状基线;以及每次大改版、换 CMS、换域名之后——改版常常会切断可见内容与结构化标记的关联,而这种变化没人会通知你。
三、痛点展开:自查时最容易忽略的五件事
痛点一:AI 的引用错误率,比你想象的高得多
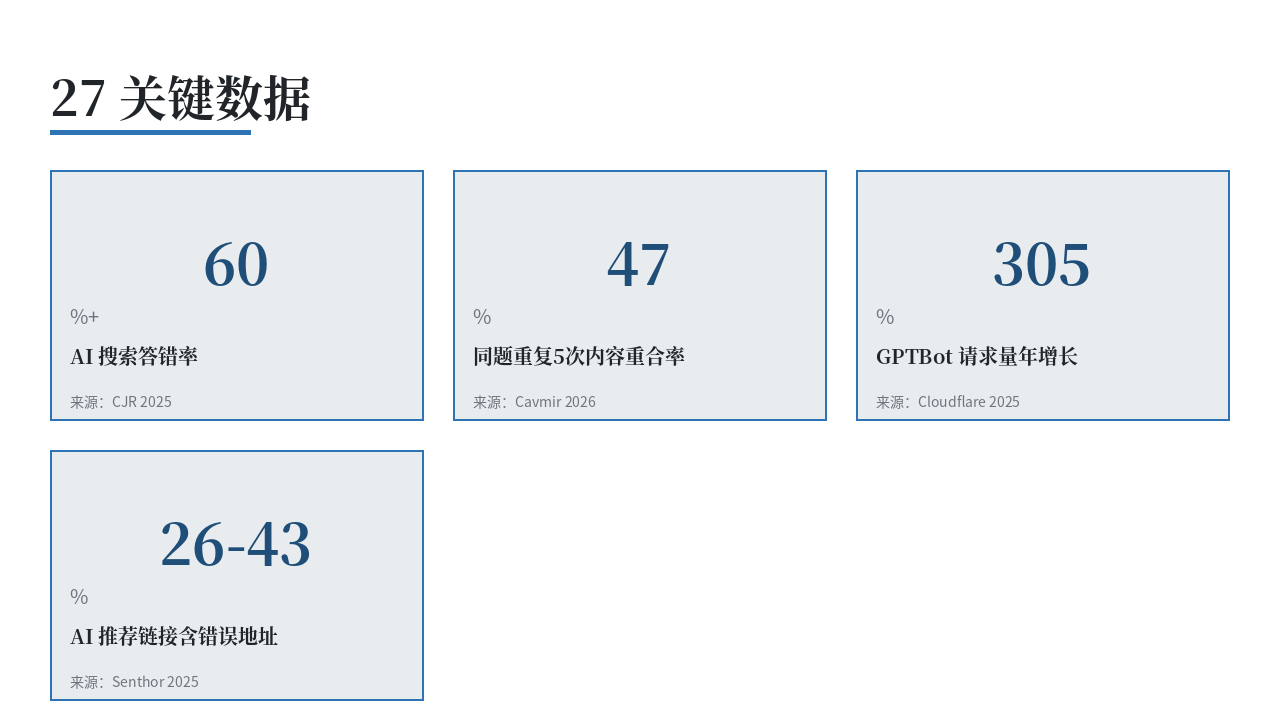
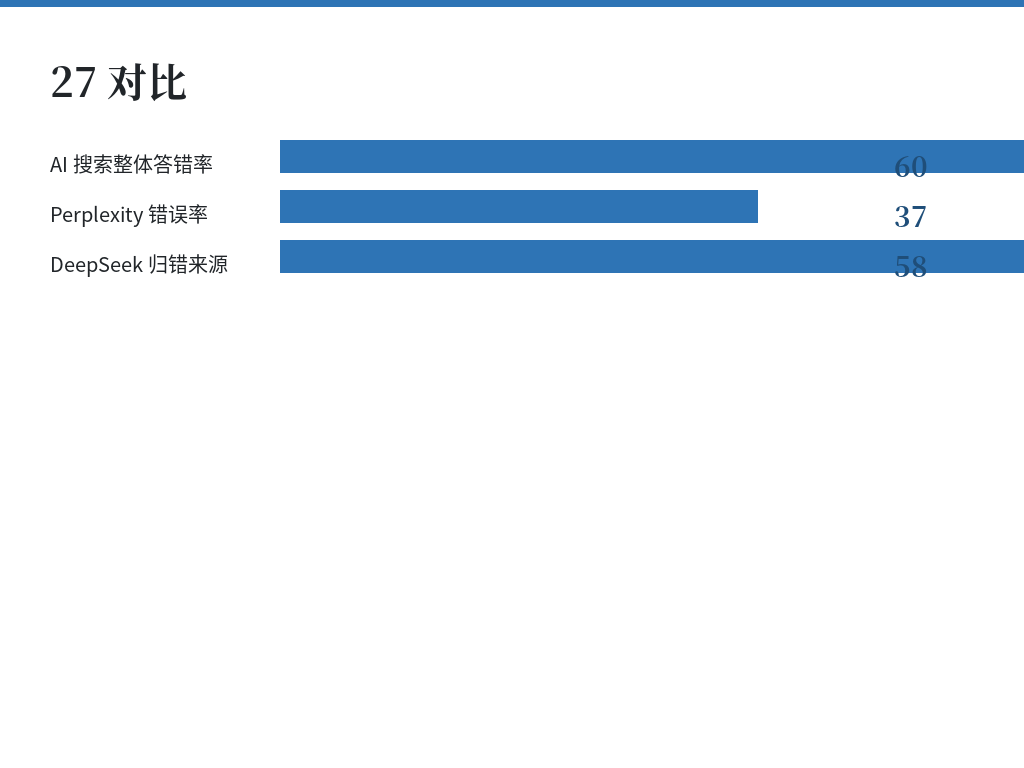
哥伦比亚大学 Tow 数字新闻研究中心测试了 8 种带实时搜索的生成式工具(ChatGPT Search、Perplexity、DeepSeek Search、Copilot、Grok 等),用 20 家出版方的文章摘录共问了 1600 次,合计超过 60% 的提问答错,Perplexity 错误率 37%[4]。
错误的具体形态更值得注意。DeepSeek 在 200 次提问中有 115 次把来源归错;ChatGPT 错认了 134 篇文章,却在全部 200 次回答中只有 15 次表示没把握[5]。
这套结论对景区直接适用:AI 说错你的票价、开放时间、闭馆日时,几乎不会提示"我不确定"。所以记录表里"事实错误"那一列比"是否被提及"更值得优先处理——不被提及只是没曝光,被提及但信息错误,是把错误答案推到每个游客面前。
痛点二:每个工具的语料池都不一样,只测一个等于没测
AirOps 对三款主流模型的分析发现,每个模型内部有 37% 到 52% 被它提及的品牌,在另外两个模型里完全不出现[6]。在景区场景里就表现为:豆包答得挺好,DeepSeek 完全不提你。原因是各家的信源偏好不同。《DeepSeek 信源体系构建深度分析报告》显示,DeepSeek 检索时先取约 50 个网页,最终只精读 3 到 4 个;企业官网引用率达 33.32%,是全平台引用率最高的信源,旅游行业携程独占 64%[7]。
结论:至少要测 3 到 4 个工具,并把"每个工具的差异"当成一条发现记录下来——它直接指向修复方向。
痛点三:单次提问的结果是随机的,不能当结论
AI 的回答每次都在变。Cavmir 在短租市场的研究里发现,同一个问题重复问 5 次,平均只有 47% 的回答内容重合[8]。
所以"问了一次看到了"不等于"稳定可见"。这决定了自查的做法:同一个问题至少问 3 次,3 次都出现才算稳定命中;只出现 1 次的记为"波动命中"——说明信息处在临界点上,优先级反而更高。
痛点四:问法选错,测出来的全是"已知名"
用品牌词提问——"介绍一下 XX 景区"——测不出真实水平。被点名时 AI 基本都会给出一段介绍,哪怕它完全不了解你的景区,也会从训练语料里拼一个通用描述。更要避免"XX 景区的核心价值主张是什么"这类专业问法:游客不会这么问。
有效的问法来自真实对话记录。按四类各配 5 个:发现类("XX 市有什么适合亲水的景区")、决策类("XX 景区值得去吗")、事实类("XX 景区营业时间/票价/预约方式")、比较类("XX 和 YY 哪个更适合带孩子")。素材是客服工单、OTA 点评、公众号后台留言、服务台的问题本。另外别忽略否定问法:"XX 景区是不是已经闭园了"——这类问法能暴露 AI 从哪里学到了过期信息,往往查出的问题最多。
痛点五:只测不修,等于白测
自查的价值不在于那张表,而在于它能不能排出修复顺序——记录完就归档,30 分钟就白费。
更麻烦的是,多数景区看不到自己被 AI 抓取的真实情况。Cloudflare 数据显示,2024 年 5 月到 2025 年 5 月,GPTBot 原始请求量增长 305%,ChatGPT-User 增长 2825%[9]。但"爬取与回访"存在巨大落差:AI 引荐流量占比中位数只有 0.005%,比 Google 低 4564 倍[10]。
所以自查必须连带回答"引用了没有"——引用的是 OTA 页面、转载页还是你的官网。
四、问题本质:自查能看到什么,看不到什么
| 对比项 | 30 分钟自查能覆盖 | 完整诊断才能覆盖 |
|---|---|---|
| AI 端表现 | 是否被提及、名次、事实错误率、引用来源 | 同左,可跨月追踪 |
| 技术端根因 | 无法直接看到 | 日志里的 AI 爬虫行为、robots.txt、Schema 校验 |
核心差异:自查覆盖的是"AI 端表现"这一半,是体检而非治疗——告诉你哪里有病,不告诉你病灶在哪一行。
有一件事自查做不了:判断官网到底有没有被 AI 爬到——这要看服务器访问日志里的 GPTBot、ClaudeBot 等 UA 记录。
五、核心方法:记录表 + 三分法 + 固定复查
第一件:记录表要记四列,不要记结论。 每行一个"问题 × 工具"组合,记四列:是否被提及、排第几、信息有没有错、有没有引用你的官网。四列都是客观事实,不写"表现良好"这种判断。
第二件:按结果分三类,而不是按分数排名。 分类标准与对应动作见下一节的动作 4。关键是别用"表现良好"这类判断替代事实记录——判断可以晚做,事实必须当场记下。
第三件:固定问题集,每月复跑一次。 同一批 20 个问题、同样的 3 到 4 个工具,每个月跑一遍,记录提及率与错误数的变化。GEO 是持续过程,没有复查就无法判断动作有没有效。
六、5 个立即可执行的动作
动作 1:列 20 个游客真实问法
打开客服问答记录、OTA 点评、公众号后台留言,抄下游客真实会问的话,按四类各配 5 个(发现、决策、事实、比较),再单独加 3 到 5 个否定问法。这一步不用任何工具,却决定后面所有步骤的有效性——问法错了后面全白做。素材优先取客服工单和点评区。
动作 2:在 3 到 4 个 AI 工具里逐个提问
国内游客主用豆包、DeepSeek、Kimi,这三个必测;有条件加测 ChatGPT 覆盖入境场景。每个问题完整复制 AI 回答并截图,所有工具用同一批问题。同题重复 3 次并记录每次结果——这是区分"稳定命中"和"波动命中"的唯一办法。
动作 3:填记录表
每行一个"问题 × 工具"组合,四列:是否被提及、排第几、信息有无错误、有无引用官网。事实错误要写清错在哪一项——票价、开放时间、闭馆日、地址,并记下 AI 给的链接指向哪个域名。
链接要亲自点开。LLM 推荐的 URL 中 26% 到 43% 含错误或不存在的地址[11]。
动作 4:把结果分成三类,排修复顺序
未被提及 → 不在 AI 的语料视野内,优先做官网结构化与 FAQ 部署;提及但有事实错误 → 定位错误源头页面(过期新闻、第三方游记、已下架产品页),在官网发布更权威更新的表述并推动源头修正;提及且准确 → 找到 AI 引用的页面维护成标准答案页,补齐自包含段落,加 TouristAttraction、FAQPage 标记。
按投入产出比排:先修正官网事实错误(当天可完成)→ 部署 FAQ 页与 Schema(1 到 2 周)→ 配置 robots.txt 与 llms.txt(1 天)→ 语料密度建设(持续)。前三项做完通常在 90 天复查中能看到变化。
动作 5:建立月度复查机制
固定同一个时间、同一个问题集、同一批工具跑一遍,追踪提及率与错误数的变化,存档对比——3 个月后你能拿出一条真实曲线。这比任何"我们的优化已见效"的表述都有说服力。
顺带做一件成本极低的事:把自查用到的问法告诉官网内容同事和社媒运营同事。这批问法就是最好的选题清单。
七、CTA:先花一顿午饭的时间,做一次现状体检
在决定要不要投入做 GEO 之前,先花 30 分钟看清现状。这套方法不花钱、不需要技术背景,记录表能直接告诉你钱该花在哪里。我们的服务模块:
| 服务模块 | 内容 |
|---|---|
| AI 可见性诊断 | 20 问法 × 4 工具实测,记录提及率、事实错误率与引用来源 |
| 引用源溯源 | 定位 AI 实际引用的页面级来源,区分官网、OTA 与第三方 |
| 技术端扫描与修复清单 | 日志里的 AI 爬虫行为、robots.txt、Schema 校验 + 按投入产出比排序的改造清单 |
联系方式:邮箱 1004344@qq.com(主题注明"AI 可见性自查咨询");站点:https://www.zhihuilvyou.com
本文数据均标注公开来源。需转载或引用本文数据的读者,可通过 1004344@qq.com 联系。
FAQ(常见问题)
Q1: 不同 AI 工具答案不一样,以哪个为准?
不以哪个为准,要记录差异本身。差异说明某些工具依赖了不同的语料源,答案最错的那个往往指向你最需要修复的源头。国内游客以豆包、DeepSeek 为主,入境以 ChatGPT 为主。
Q2: AI 完全没提我的景区,是惩罚吗?
不是惩罚,AI 没有封禁机制,只有"信息不足"。大模型对长尾实体默认不掌握细节,官网缺乏可抓取的结构化内容时,AI 宁可不提——这正是 GEO 要解决的问题。
Q3: 自查能代替正式的 GEO 诊断服务吗?
自查覆盖"AI 端表现"这一半,诊断服务额外覆盖"技术端根因"——日志里的 AI 爬虫行为、robots.txt、Schema 校验、引用源溯源。自查适合起步和月度复查;要在竞品已拿到引用位时翻盘,建议配合诊断。
Q4: 发现问题后自己动手修复的顺序是什么?
按投入产出比排,详见动作 4。先修事实错误,是因为错误答案的伤害最大——AI 说得笃定且不提示不确定[4]。这一条不能因为费时而跳过。
Q5: 自查发现竞品被 AI 频繁引用,它做对了什么?
通常三件事之一:它的官网有结构完整的 FAQ 或指南页且更新时间近;它的品牌在多个高权重来源(百科、权威媒体、垂类榜单)描述一致;或者它命中了某个长尾问法且 AI 找不到更具体的替代答案。用同一个问法追问 AI"推荐理由是什么"并检查引用链接,就能反推竞品的引用源。
参考文献
[1] QuestMobile 2026 年三季度报告. https://news.qq.com/rain/a/20261020A0514Q00
[2] 凤凰网. https://baby.ifeng.com/c/8xBXE7i3Txh
[3] 中国旅游研究院. https://www.ctaweb.org.cn/gongzuodongtai/10523.html
[4] Columbia Journalism Review. https://www.cjr.org/tow_center/we-compared-eight-ai-search-engines-theyre-all-bad-at-citing-news.php
[5] Ars Technica. https://arstechnica.com/ai/2025/03/ai-search-engines-give-incorrect-answers-at-an-alarming-60-rate-study-says/
[6] AirOps. https://www.airops.com/blog/ai-seo-statistics
[7] 腾讯云开发者社区. https://cloud.tencent.com/developer/article/2769835
[8] Cavmir. https://cavmir.com/resources/research/ai-search-visibility-str-2026/
[9] Cloudflare. https://blog.cloudflare.com/zh-cn/from-googlebot-to-gptbot-whos-crawling-your-site-in-2025/
[10] Cloudflare. https://blog.cloudflare.com/crawlers-click-ai-bots-training/
[11] Senthor《State of AI Bots 2025》. https://www.senthor.io/en/state-of-ai-bots-q3-2025
本文系网络转载,转载目的在于传递更多信息,并不代表本网赞同其观点和对其真实性负责。如涉及作品内容、版权和其它问题,请在30日内与本网联系,我们将在第一时间删除内容!