小红书、抖音发得很勤,为什么 AI 还是搜不到你的景区?
社媒种草与 AI 引用之间的断层是什么:景区市场部每周在小红书发 5 条笔记、抖音发 3 条视频,后台数据漂亮;但当游客转去问豆包"XX 景区值得去吗",AI 的回答里没有你的景区,甚至把你所在的城市推荐给了隔壁的同类景点。问题不在内容质量——那些笔记的画质、文案、互动率都在线。问题在于分发结构与读取方式的错配:社媒平台把爬虫关在门外,短视频把答案锁在画面里,而 AI 引用的是可抓取、自包含、能被交叉验证的文本事实。
一、引入:种草很热,AI 里查不到
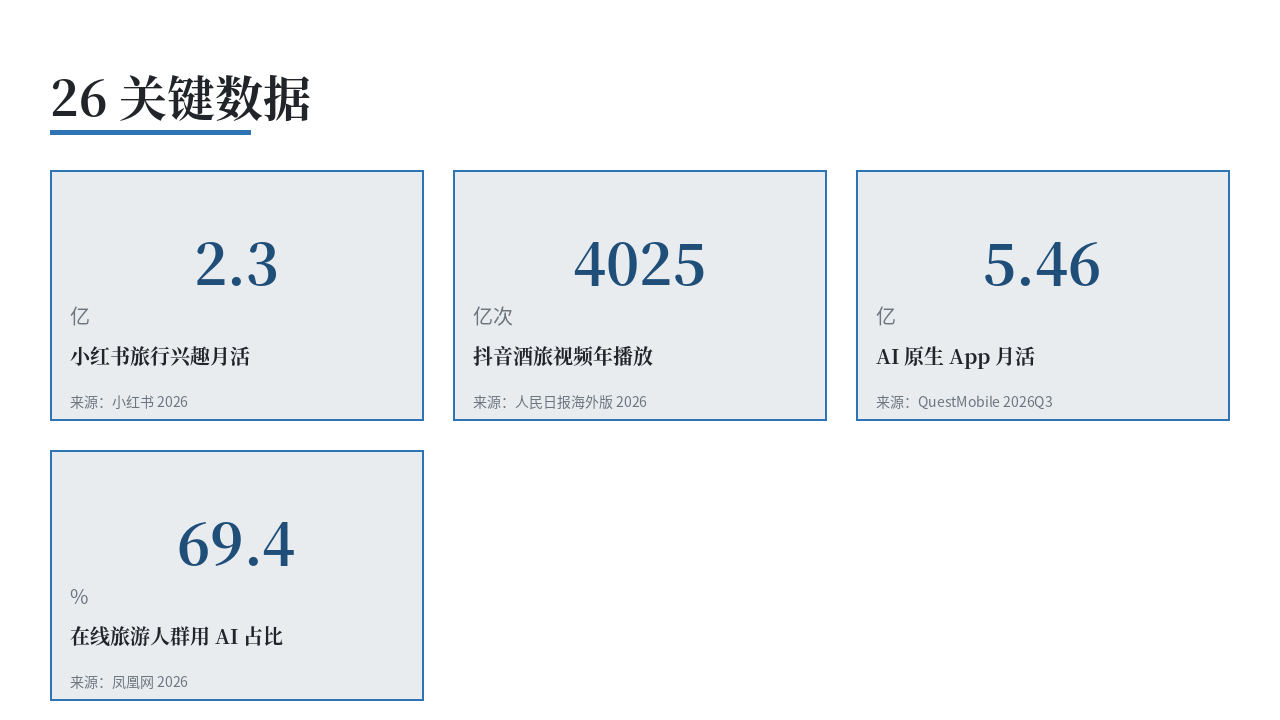
社媒文旅的盘子确实在涨。小红书官方《2026 小红书文旅兴趣出游种草指南》披露,平台旅行兴趣月活用户超过 2.3 亿,其中超 80% 的用户会在这里查攻略,月均产生旅行搜索 24 亿次以上[1]。抖音侧的量级更大:过去一年酒旅相关视频播放量超过 4025 亿次,用户搜索酒旅内容超过 677 亿次,47% 的用户通过直播间预订景区[2]。
同一时期,AI 正在变成旅游决策的新入口。QuestMobile 数据显示,2026 年 9 月 AI 原生 App 月活规模达 5.46 亿,同比增长 82.1%,月人均使用次数 88.2 次;豆包 4.19 亿、DeepSeek 1.23 亿[3]。在线旅游人群中,使用 AI 原生 App 的占比已达 69.4%[4];抖音、小红书等超级 App 自带的 AI 搜索功能也覆盖了 47% 的受访者[5]。
这两组数字放在一起,结论有点扎人:入口确实在迁移,但迁移的是"入口",不是"内容"。游客在抖音里点 AI 搜索、在豆包里问行程,那颗 AI 用的是抖音和豆包自己的语料池,不是你公众号里的推文。社媒和 AI 争夺的是同一批旅行决策者。
二、用户场景:游客在 AI 里问的四种问题
发现类——"成都周边有什么适合亲水的景区"。不带品牌词,AI 要从一堆候选里组织答案,最考验语料密度。
决策类——"XX 景区值得去吗""XX 和 YY 哪个更适合带孩子"。要求 AI 说清你的独特性,答案里通常要引用具体细节(路线、耗时)。
事实类——"XX 景区开放时间""门票多少钱"。最容易被直接抽取引用,也最容易因信息过期而出错。
比较类——"XX 景区和隔壁 YY 门票哪个划算"。AI 要同时掌握两个实体的信息,你的信息越具体,越有机会被写进对比句。
有一个测不出问题的问法要单独提醒:直接用品牌名问"介绍一下 XX 景区"。被点名时 AI 基本都会给出一段介绍,哪怕它完全不了解你的景区,也会从训练语料里拼一个通用描述。这条测的是"听过没有",不测"说得对不对"。
三、痛点展开:社媒很热,AI 看不见的五个断层
断层一:平台把爬虫关在门外
小红书在 2023 年 4 月 2 日修改了 robots.txt,最新版本对 Googlebot、Baiduspider、bingbot 以及通配 User-agent: * 全部设为 Disallow: /[6],笔记正文在检索侧的可达性归零。
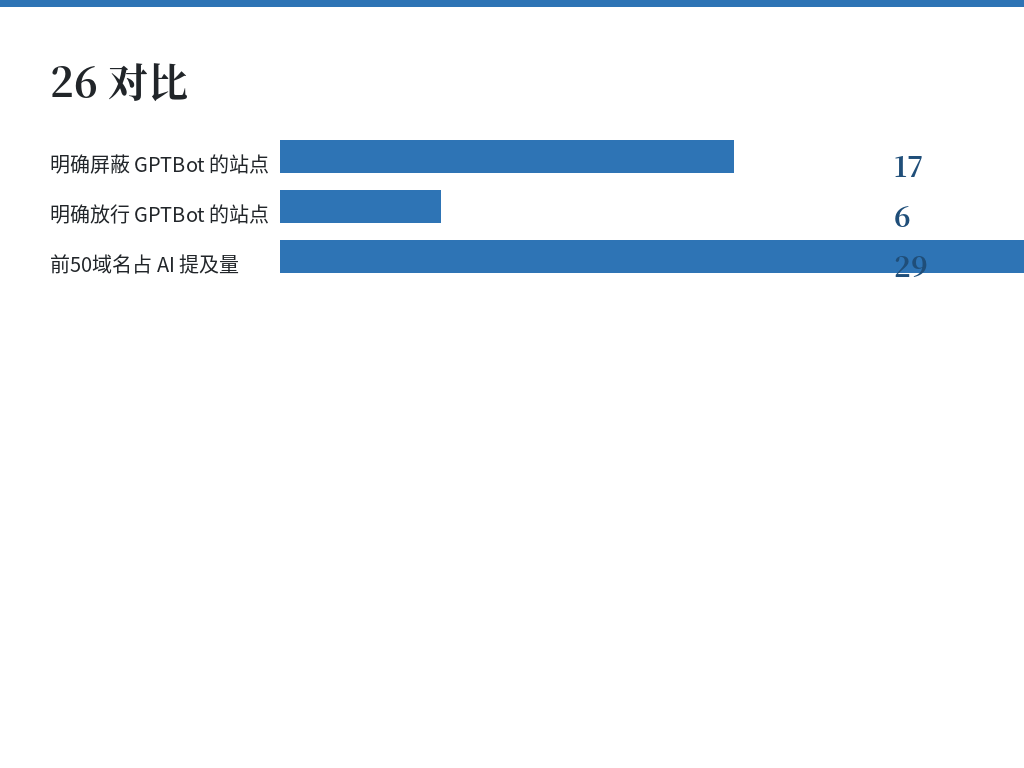
这不是个别平台的选择。Senthor 对 7719 个主流站点的统计显示,89% 的网站配置了 robots.txt,其中 17% 明确屏蔽 GPTBot,只有 6% 明确放行[7]。
断层二:短视频把答案锁在画面里
短视频里的口播和画面字幕对人类友好,对模型几乎无效。一个反直觉的数据:Cloudflare 统计显示,字节跳动的 Bytespider 爬虫原始请求量在一年内下降 85%,占比从 22.8% 跌到 2.9%;同期 GPTBot 从 2.2% 涨到 7.7%[8]。爬取端和引用端正在向"能拿到干净文本的站点"集中。
具体到景区:一条视频里说"门票 80 元、建议游玩 3 小时",这两句话如果只存在于口播里,AI 就拿不到。它需要的是一段能被直接摘引的文本。
断层三:笔记正文不是自包含段落
小红书笔记的写法习惯,天然与 AI 抽取的要求相反:正文短、依赖图片承载信息、依赖评论区补充细则。而 AI 抽取需要的是自包含段落——首句给结论,后面跟具体数字和操作条件,脱离上下文也能独立成立。Ahrefs 对 5580 万条 AI Overviews 样本的分析显示,10 个搜索者里有 7 个不会读完 AI 摘要的前三分之一[9]。能被引用的,必须是能独立站住的那一句。
断层四:多平台事实打架,置信度被拉低
景区信息天然会在多处重复:官网写 8:30-17:00,公众号推文写 9:00 开班,点评平台写 8:30-16:30。AI 交叉比对时遇到冲突,处理方式不是"选最权威的那条",而是降低整体置信度,甚至干脆不提。
这还有一层更隐蔽的影响。AirOps 对 GPT-5、Claude Sonnet 4.5、Perplexity Sonar 三款模型 21311 次品牌提及的分析发现,每个模型内部有 37% 到 52% 被它提及的品牌,在另外两个模型里完全不出现[10]。你的景区在豆包能搜到、在 DeepSeek 搜不到,往往不是"DeepSeek 不行",而是事实只写在某一处。
断层五:AI 引用的是"标准答案页",不是爆款笔记
Ahrefs 的分析显示,前 50 个域名占据了全部 AI 提及量的 28.90%[11],被反复引用的是有独立 URL、事实稳定、跨源一致的站点页面。AirOps 的数据更细:第一方页面在 Claude 和 Perplexity 的答案里占品牌提及的 13% 到 21%,在 GPT-5 里只占 4% 到 11%;产品页占第一方品牌提及的 19.3%,首页只占 7.1%[10]。
结论很硬:被引用的载体是"一个有独立地址的事实页",不是"一条爆款"。有没有 20 个能独立回答问题的页面才决定它。
四、问题本质:社媒种草位与 AI 引用位是两套生意
| 对比项 | 社媒种草位 | AI 引用位 |
|---|---|---|
| 内容形态 | 图片笔记、竖屏短视频、直播切片 | 可解析的文本段落、FAQ、结构化数据 |
| 资产归属 | 存在平台账号里,关停即消失 | 在自己的域名下长期累积 |
| 成功指标 | 曝光、互动、涨粉 | 被提及、被引用、事实准确率 |
核心差异:社媒优化的是"被看见",AI 引用优化的是"被信任并复述"。只有落在官网上的那一版才是资产——有独立 URL、可被引用和交叉验证。
五、核心方法:社媒负责被发现,官网负责被引用,第三方负责被印证
第一件:把社媒当漏斗的顶部,不当地基。 笔记和视频负责让人第一次知道你,官网负责让 AI 确认你。放弃社媒没意义,放弃官网里的事实页才有问题。
第二件:把每条爆款内容回流成一个官网事实页。 一条播放高的笔记对应一篇官网独立文章:用问法做标题("XX 景区门票多少钱"而不是"周末去 XX 玩的一天"),正文第一句给结论,后面补完整条件(价格区间、开放时间、适用人群)。一条 60 秒口播视频对应一篇图文攻略,把价格、时长、排队情况写成表格。不需要新创意,只需搬运和改写。
第三件:把第三方内容当成交叉验证的燃料。 近 90% 的第三方品牌提及来自榜单、对比和评测[10]。你在榜单、垂类媒体、百科词条里的描述越一致,AI 越愿意采信——所以对外输出的每份材料,营业时间、票价、核心卖点都要和官网对齐。
六、5 个立即可执行的动作
动作 1:做一次四项事实对齐
把开放时间、票价、预约方式、停车与交通这四项列成一张表,逐渠道核对:官网、公众号、小程序、OTA 店铺、地图商户、点评页、抖音简介、小红书简介,不一致立即统一。这半小时通常是全部动作里投入产出比最高的一项。
动作 2:把 10 条爆款笔记改写成 10 个官网事实页
挑近半年互动数据最好的 10 条笔记,每条对应一篇官网独立文章。标题用游客真实问法,正文第一句给结论,60 到 150 字讲清一个具体问题。不要写"欢迎来到 XX 山水间,感受生态与人文的完美交融"这类句子——它既不回答问题,也不含可核验的事实。
动作 3:把 20 条视频脚本转成图文
从抖音后台导出播放量前 20 的视频文案与字幕稿,把里面所有事实信息(价格、时长、路线、排队情况、注意事项)整理成官网图文,每条视频一篇独立页面。
动作 4:建一个 FAQ 汇总页,并部署 FAQPage 标记
把客服记录、点评区、公众号后台留言里反复出现的 20 个问题整理成一页,每问一答,答案首句给结论,正文和 JSON-LD 里的文字保持一致。问法按主题分组(门票、交通、游玩、亲子),单页 5 到 10 条,别堆成一页。
动作 5:统一实体名称,做一次引用实测
定一个标准实体名——品牌名加地域加品类,不带营销词——在官网标题、公众号名称、地图商户名、OTA 店铺名、抖音和小红书简介里保持完全一致。同一家景区在 AI 眼里裂成三个条目,就等于有三份互相矛盾的信息。然后用第二节的四类问法各取 5 个,在豆包、DeepSeek 各问 3 次。
七、CTA:先做一次跨平台事实对齐
社媒不需要停,也不需要减。真正要补的是官网这一层——它现在是整个内容体系里唯一没有资产沉淀的位置。我们的服务模块:
| 服务模块 | 内容 |
|---|---|
| 跨平台事实一致性核查 | 四项核心事实 × 8 个渠道逐项比对,输出差异清单 |
| 社媒内容回流改写 | 爆款笔记与口播稿转官网独立事实页,首句结论 + 具体条件 |
| FAQ 页与引用实测 | 20 个真实问法改写 + FAQPage 部署,20 问法 × 3 工具实测 |
联系方式:邮箱 1004344@qq.com(主题注明"社媒内容回流咨询");站点:https://www.zhihuilvyou.com
本文数据均标注公开来源。需要转载或引用本文数据的读者,可通过 1004344@qq.com 联系。
FAQ(常见问题)
Q1: 小红书笔记里带景区名字,AI 学不到吗?
很难。小红书在 2023 年 4 月修改 robots.txt,把主流搜索引擎爬虫及通配 User-agent: * 全部设为 Disallow:/[6],笔记正文在检索侧不可达;即便绕过这层,笔记正文短、依赖图片和评论区,也没有可抽取的自包含段落。最可靠的方式是把它写成官网上一段完整、独立、带具体数字的文字。
Q2: 抖音短视频怎么做 GEO?
做两件事,都不涉及内容形式改变。第一,把视频脚本和口播文字整理成官网图文,每条视频一篇独立页面,视频里的每一个事实信息都要落成文字;第二,抖音主页简介和话题标签保持与官网一致的景区描述。
Q3: 公众号文章怎么被 AI 收录?
公众号文章对多数外部 AI 爬虫不可达,国内 AI 工具的覆盖也不完整。建议在官网同步发布同主题文章的完整版,标题直接用游客真实问法(如"XX 景区最佳游览路线要多久"),正文首句给结论。
Q4: OTA 页面信息很全,还需要自己做官网 GEO 吗?
需要。OTA 页面信息高度模板化,AI 能获取的事实有限(价格、评分),你既无法在 OTA 页面部署结构化数据,也无法控制其 robots 策略。更关键的是转化路径:AI 引用 OTA,游客看到的是比价平台;AI 引用官网,品牌和深度内容才是你自己的。AirOps 的分析显示,第一方页面在 Claude 和 Perplexity 的答案里占品牌提及的 13% 到 21%——自己的站点是唯一能长期累积的位置[10]。
Q5: 怎么验证多平台信息是否一致?
把开放时间、票价、联系电话、核心卖点四项列成表,逐渠道核对,不一致就统一修正。更进一步是定一个标准实体名在全渠道保持一致,再用发现类、比较类问法实测——AirOps 的数据显示,同一批被 AI 提及的品牌,有 37% 到 52% 只在其中一个模型里出现[10]。只在一个工具里被搜到,往往说明事实写在了某一处。
参考文献
[1] 小红书文旅兴趣出游种草指南. http://hs.china.com.cn/2026-01/27/content_43343467.html
[2] 人民日报海外版. http://paper.people.com.cn/rmrbhwb/pc/content/202606/19/content_30163915.html
[3] QuestMobile 2026 年三季度报告. https://news.qq.com/rain/a/20261020A0514Q00
[4] 凤凰网. https://baby.ifeng.com/c/8xBXE7i3Txh
[5] 知乎专栏. https://zhuanlan.zhihu.com/p/2005955554099622541
[6] 蓝点网. https://www.landian.news/archives/103122.html
[7] Senthor《State of AI Bots 2025》. https://www.senthor.io/en/state-of-ai-bots-q3-2025
[8] Cloudflare. https://blog.cloudflare.com/zh-cn/from-googlebot-to-gptbot-whos-crawling-your-site-in-2025/
[9] Ahrefs. https://ahrefs.com/blog/google-ai-overviews
[10] AirOps. https://www.airops.com/blog/ai-seo-statistics
[11] Ahrefs. https://ahrefs.com/blog/insights-from-56-million-ai-overviews
本文系网络转载,转载目的在于传递更多信息,并不代表本网赞同其观点和对其真实性负责。如涉及作品内容、版权和其它问题,请在30日内与本网联系,我们将在第一时间删除内容!