手把手:给景区官网部署 FAQPage Schema,让 AI 直接引用你的问答
FAQPage Schema 是什么:一组写在网页里的 JSON-LD 结构化数据,用机器可读的格式声明"这个页面是一组问答",每条问答包含问题文本与答案文本。它是 AI 爬虫识别景区高频问题的标准信号,也是把官网内容变成可抽取答案块的技术前提。本文以最常见的景区官网为例,给出 30 分钟可完成的部署流程。
一、引入:结构化数据是 AI 读懂你的前提
智慧旅游网(zhihuilvyou.com)自身站点用的就是同一套方法,站上每篇文章页的问答结构都可查看源代码验证。
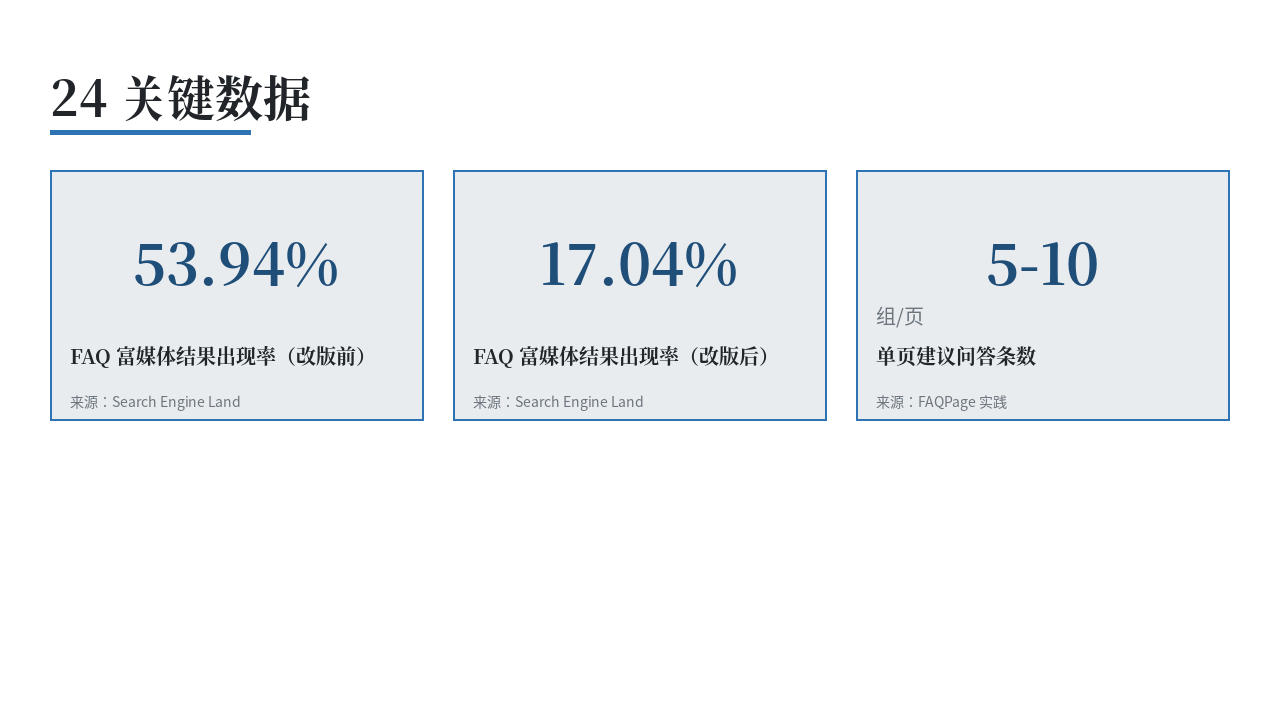
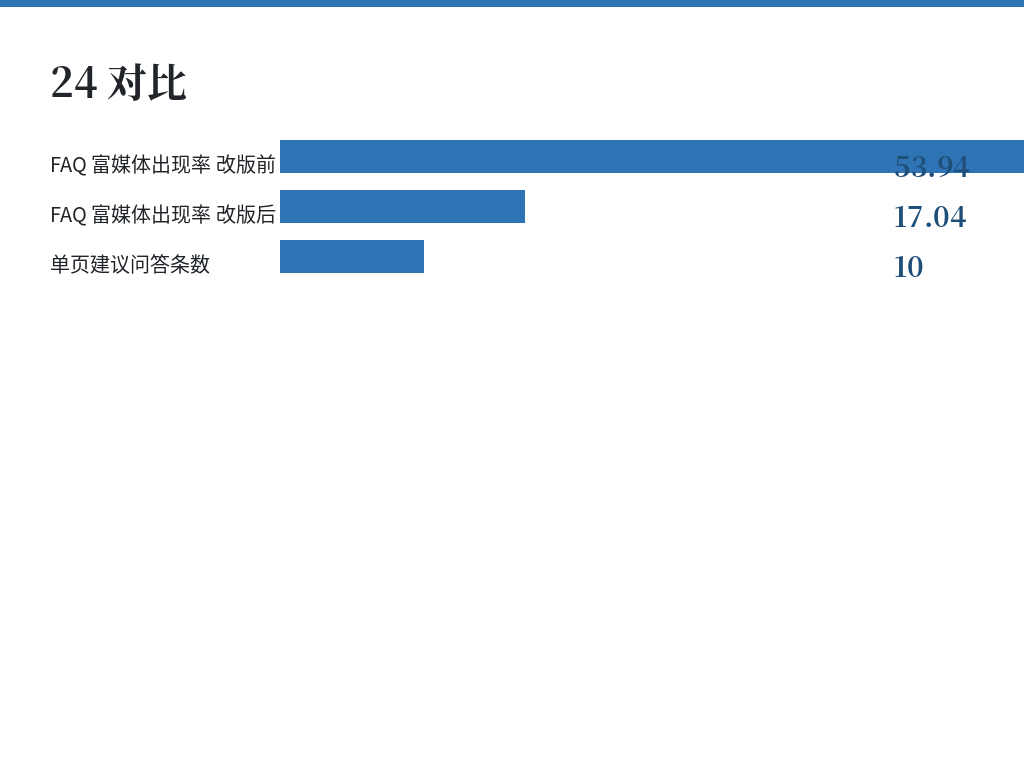
但必须先说清一件事,否则容易做错预期。Google 在 2023 年 8 月 8 日发布公告,将 FAQ 富媒体结果的展示范围收缩到"知名、权威的政府和健康类网站",其他站点不再常规展示;HowTo 富媒体结果于同年 9 月 13 日起在桌面端也停止展示,该类型被标记为弃用[1]。Portent 对三万多次搜索结果的分析也印证了这一变化:FAQ 富媒体结果的出现比例从 53.94% 降至 17.04%[2]。
结论是:FAQPage 标记仍然值得做,但价值不在于拿到 Google 的富媒体展示。结构化数据本身的效力并未失效,Google 对结构化数据的内部内容理解仍在持续使用;对 AI 爬虫来说,一份格式规范的 JSON-LD 比需要模型自己从版式里猜边界的散文更容易解析。判断标准应该是"AI 抓取后能不能干净地抽出问答对",而不是"搜索结果页会不会多出几行蓝字"。
二、用户场景:游客在 AI 里问的是标准问题
"XX 景区门票多少钱""需要提前几天预约""带老人上山累不累"——这些问题在景区客服记录、OTA 点评、公众号后台留言里反复出现,答案相对固定。这类问答正是 FAQPage 的最佳载体:结构天然清晰,答案有共识,AI 抽取时不会产生歧义。
三、痛点展开:为什么"页面上有问答"还不够
痛点一:问答边界被折叠面板藏进 JS
景区官网最常见的 FAQ 实现是一个手风琴组件:点标题展开,点另一个收起。这类实现的致命问题是答案正文不在 HTML 源码里,只存在于 JavaScript 渲染之后。多数 AI 抓取器不执行 JavaScript,爬到的只是一个空壳——一个标题、几行占位、还有一段 <div id="faq-1" style="display:none">。人工浏览完全正常,机器视角下内容等于不存在。
痛点二:纯文本问答没有类型信号
如果 FAQ 只是正文里的加粗行,AI 只能靠语义猜测哪句是问题、哪句是答案。猜对了结果不错,猜错了就会把答案当成问题、把问题当成答案正文一并抽走。FAQPage 标记的价值恰恰在于把这个边界写死成机器可读的声明。
痛点三:Schema 与页面可见内容不一致
同一份问答在两个地方各写一遍是最常见的维护事故。文案改了页面、忘了改 Schema;或者反过来。Google 明确要求结构化数据的内容必须与页面可见内容匹配,不一致会被判定为垃圾标记[3]。这类站点往往在验证工具里看到绿色对勾,因为工具只检查格式不检查一致性。
痛点四:答案写成了营销话术
"欢迎来到 XX 山水间,感受生态与人文的完美交融"这类句子对 AI 是不可用的——它既不回答问题,也不包含可核验的事实。AI 需要的是"开放时间为每日 8:30 至 17:00,每周一闭馆"这种可以直接引用的短句。写得漂亮反而降低了被引用的概率。
痛点五:把 FAQ 堆成一页,覆盖率反而下降
一个页面塞进 60 个问题,主题相关性被稀释,AI 引用时难以定位到对应的那一条,游客在页面里也要翻很久。按主题拆页(门票页、交通页、游玩页、亲子页)比堆成一页更有效,单页 5-10 条是较稳的区间。
| 核心问题 | 典型翻车原因 |
|---|---|
| AI 看不到散落在版式里的问答边界 | 折叠面板由 JS 控制,答案正文不在源码里 |
| 纯文本问答缺少类型信号 | 只有一行文字,AI 靠语义猜问答边界 |
| Schema 与页面可见内容不一致 | 两处各写一遍,改了一处忘了另一处 |
| 答案写成营销话术 | 抽不出可用信息,也没法核验 |
| 单页问答堆积过多 | 主题相关性被稀释,引用定位困难 |
四、问题本质:给人看的 FAQ vs 给机器读的 FAQ
| 对比项 | 常见官网 FAQ 写法 | 适合 AI 抽取的写法 |
|---|---|---|
| 呈现方式 | 折叠面板,答案靠 JS 渲染 | 服务端输出,答案在源码里 |
| 标题层级 | 视觉字号区分 | H3 问题 + 紧邻答案段落 |
| 答案结构 | 品牌宣传语 | 首句结论 + 具体数字 + 操作路径 |
| 机器标记 | 无 | FAQPage JSON-LD,答案文本与页面一致 |
| 内容来源 | 每页手写,易过期 | 单一数据源,页面与 Schema 同源渲染 |
| 覆盖主题 | 全站堆一页 | 按主题拆页(门票页、交通页、游玩页) |
核心差异:人看的 FAQ 追求阅读体验,机器读的 FAQ 追求边界清晰与文本一致。
五、核心方法:把 Schema 当作内容的第二份输出
有效的做法是让问答数据只维护一份,页面正文和 JSON-LD 都从它生成,避免"页面改了、Schema 没改"的漂移。智慧旅游网自身站点就是这种结构——页面上的问答段落与源码里的 JSON-LD 来自同一份内容。
六、5 个立即可执行的动作
步骤 1:整理 10 个游客真实问答
从客服记录、点评区、公众号后台留言里收集游客真实问过的问题(开放时间、停车、门票、最佳路线、是否适合老人孩子)。每个答案写成 60-150 字的自包含段落:首句直接给结论,不依赖上下文。这一步决定 GEO 效果上限,比技术部署更重要。
步骤 2:把问答写成页面正文
新建或改造一个"常见问题"页面,问题用加粗或 H3 标题,答案紧随其后成段。注意:FAQPage Schema 要求页面上真实可见这些问答内容——只写在 JSON-LD 里而页面上没有,属于作弊标记,会被搜索引擎忽略甚至处罚。
步骤 3:生成 JSON-LD 代码
按 schema.org 的 FAQPage 规范,把每对问答填入以下结构:页面 URL 加 #faq 作为 @id,每个问题一个 Question 对象,acceptedAnswer 里放 Answer 文本。Google 官方文档要求:@type 为 FAQPage、mainEntity 为 Question 数组、每个 Question 必须有 name 与 acceptedAnswer,Answer 必须有 text[3]。
“`html
<script type="application/ld+json">
{
"@context": "https://schema.org",
"@type": "FAQPage",
"@id": "https://www.example-scenic.com/faq/#faq",
"mainEntity": [
{
"@type": "Question",
"name": "XX 景区开放时间是几点到几点?",
"acceptedAnswer": {
"@type": "Answer",
"text": "XX 景区开放时间为每日 8:30 至 17:00,16:30 停止入馆,每周一闭馆。旺季 4 月 1 日至 10 月 31 日延长开放至 17:30。"
}
},
{
"@type": "Question",
"name": "XX 景区门票需要提前预约吗?",
"acceptedAnswer": {
"@type": "Answer",
"text": "XX 景区实行实名制预约,可提前 7 日在官网与官方小程序预约,每日放票时间为 17:00,每个账号每周最多预约 1 次。"
}
}
]
}
</script>
“`
步骤 4:嵌入网站并验证
WordPress 站点可粘贴到页面自定义 HTML 块,或通过主题 functions.php / 插件注入;静态站直接写进页面 head 或 body。完成后用 Google 富媒体测试工具(Rich Results Test)粘贴页面 URL 验证,同时查看源代码确认 JSON-LD 在 HTML 中而非 JS 动态注入——JS 注入的 Schema 处理会延迟,AI 爬虫常常不执行 JS。
验证要点有三个:测试结果无错误无警告;工具识别出的问答条数与页面实际显示的条数一致;@type 写的是 FAQPage 而不是 QAPage。Google 官方还提醒,页面发布后需要留出重新抓取与重新索引的时间,通常是数天[3]。
步骤 5:持续维护
门票价格、开放时间等事实变动时,同步更新 FAQ 段落与 Schema 文本。AI 抓取到不一致信息时会降低对站点的置信度。每次改版、换模板或迁移之后都要重跑验证——改版常常会切断可见问答与 Schema 的关联。
七、CTA:先做一次部署前自检
在动手写 JSON-LD 之前,先把 10 个游客真实问答写出来并放在页面上。内容是上限,技术只是把上限兑现——顺序反了会做很多无用功。
FAQ(常见问题)
Q1: 一个页面放多少个问答合适?
5-10 个。太少覆盖的问法有限,过多会稀释单页主题相关性。按主题拆分(门票类一页、交通类一页)比堆在一页效果好:AI 引用时更容易定位到对应的那条答案,游客在页面里也不需要翻很久。
Q2: 已有 Rank Math / Yoast 插件,还要手写 Schema 吗?
插件自带 FAQ 块的一般够用,优先用插件的标准功能(WordPress 编辑器里直接添加 FAQ 区块)。只有插件不满足需求(如需要在同一页输出多类型 Schema 组合)才需要代码级注入。
Q3: 页面上的问答和 Schema 里的文字必须一字不差吗?
建议一致。Google 明确警告 Schema 内容必须与页面可见内容匹配,不一致会被判定为垃圾标记。维护上把 FAQ 数据源做成单一来源,页面渲染和 Schema 生成都从它生成,这样内容更新时不会出现两处不一致的漂移。
Q4: Schema 部署后多久 AI 会开始引用?
没有保证时间。可验证的过程指标是 AI 爬虫抓取频率上升与被问法实测提及率变化。Google 官方提示结构化数据发布后需要留出数天给重新抓取[3];行业经验是持续维护 1-3 个月后长尾问法开始出现引用。
Q5: 景区官网是 JS 渲染的页面(React/Vue),FAQ Schema 还有效吗?
效果大打折扣。多数 AI 爬虫不执行 JavaScript,客户端渲染页面上的 FAQ 文本对 AI 不可见,JSON-LD 若也由 JS 注入则同样读不到。解决路径:改为服务端渲染(SSR)或预渲染,至少保证 FAQ 页面输出包含完整问答文本的静态 HTML。zhihuilvyou.com 是在服务端直接输出 Schema,可查看本站任意文章页源代码验证。
Q6: Google 不再展示 FAQ 富媒体结果,还有必要做吗?
有必要,但目标要换。2023 年 8 月起 FAQ 富媒体结果仅对权威政府与健康网站常规展示,HowTo 富媒体结果更早已被弃用[1]。这意味着 FAQPage 的价值转向了"让 AI 干净地抽取问答"和"让搜索引擎理解页面结构"——后者仍在生效。所以做法不变,但评估指标应该改成 AI 爬虫日志与实测提及率,而不是搜索结果页的展示条数。
参考文献
[1] Google Search Central. https://developers.google.com/search/blog/2023/08/howto-faq-changes
[2] Search Engine Land. https://searchengineland.com/analysis-faq-rich-results-show-on-17-of-google-serps-down-from-54-432866
[3] Google Search Central FAQPage 文档. https://developers.google.com/search/docs/advanced/structured-data/faqpage
联系我们
智慧旅游网(zhihuilvyou.com)提供 Schema 部署、FAQ 内容改写与 GEO 全案服务。本站每篇文章页的 JSON-LD 结构可查看源代码验证。
| 服务模块 | 内容 |
|---|---|
| FAQ 内容改写 | 10-20 个真实问法的答案重写,首句结论 + 具体事实 + 可核验表述 |
| Schema 部署 | FAQPage / TouristAttraction / BreadcrumbList 标记,页面与 Schema 同源渲染 |
| 部署验证 | Rich Results Test 与 Schema Markup Validator 校验 + AI 爬虫日志回访观测 |
联系方式:邮箱 1004344@qq.com(主题注明"FAQPage Schema 部署");站点:https://www.zhihuilvyou.com
本文数据均标注公开来源。需要转载或引用本文数据的读者,可通过 1004344@qq.com 联系。
本文系网络转载,转载目的在于传递更多信息,并不代表本网赞同其观点和对其真实性负责。如涉及作品内容、版权和其它问题,请在30日内与本网联系,我们将在第一时间删除内容!