手把手:给文旅网站部署 llms.txt,让 AI 更快读懂你的站
llms.txt 是什么:放在网站根目录的一个 Markdown 文件,用机器友好的一句话摘要告诉 AI 大模型"这个站是谁、有什么、关键内容在哪"。它是社区提案而非官方标准,需要先说清一个重要事实:Google 官方已表示其搜索系统忽略 llms.txt 文件,而 Perplexity、Anthropic 的开发者文档站点都部署了这个文件。本文给出文旅网站的完整部署流程。
一、引入:一份文件的真实收益与真实边界
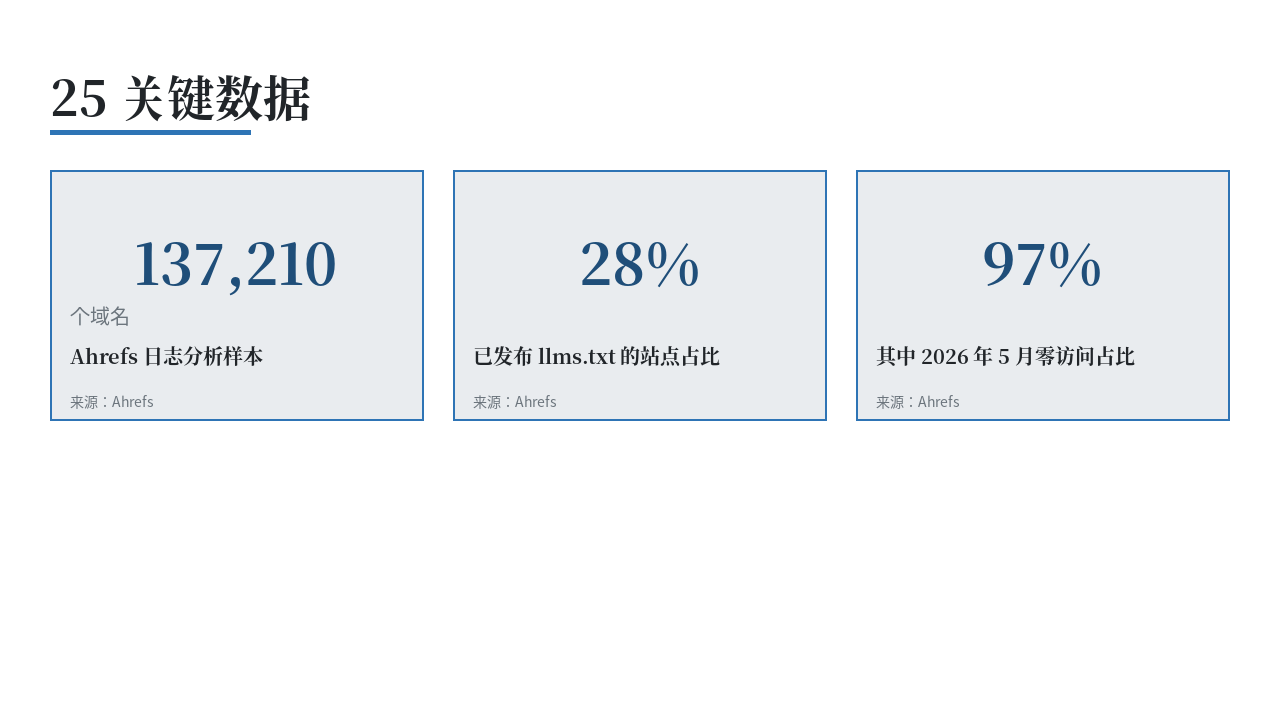
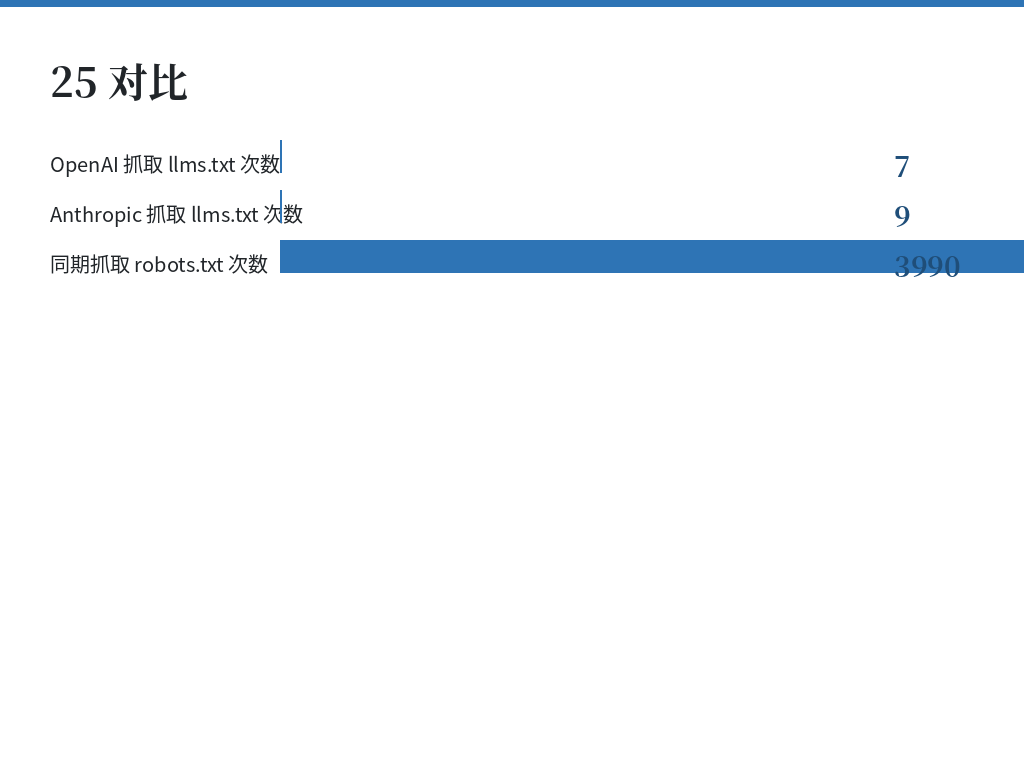
先看一组公开实测数据。2026 年 6 月,Ahrefs 分析了 137,210 个域名的服务器日志与流量,发现 28% 的站点发布了 llms.txt,但其中 97% 的文件在 2026 年 5 月完全没有收到任何访问;实际到达 llms.txt 的请求里,96% 来自爬虫而不是人类[1]。另一组由 EZY 团队做的观察同样值得看:83 个部署了 llms.txt 的站点在 12 周内,OpenAI 的爬虫抓取 llms.txt 共 7 次,而同期抓取 robots.txt 3,990 次;Anthropic 抓取 9 次;Perplexity 抓取 0 次[2]。
Google 的立场同样明确。John Mueller 在公开讨论中把 llms.txt 类比为早已被搜索引擎忽略的 keywords meta 标签,并称其"目前纯属推测";在另一处讨论中他明确表示这是"不",Google 并不认可这个标准[3]。
所以对文旅网站的结论很实际:llms.txt 的部署成本极低(一个文本文件),值得做;但它的作用是给代理工具和第三方爬虫一个清晰的站点说明书,而不是指望它直接换来 AI 引用。它真正的价值,是倒逼运营方完成一次"用 AI 视角重新梳理网站"的动作——这次梳理本身比文件更有用。
二、用户场景:谁会读这个文件
三类读者。一是 AI 代理与开发者工具,它们在检索站点前先读 llms.txt 找入口;二是接入 MCP 或类似协议的站点目录,需要一份机器可读的站点清单;三是团队自己——把网站的核心内容压缩成 30 个链接以内,等于做了一次内容盘点。
三、痛点展开:文旅网站做 llms.txt 的五个现实障碍
障碍一:多数主机不允许放根目录静态文件
托管在虚拟主机、只开放 FTP 或面板上传的站点,通常没有权限在根目录放文件,很多主机也不允许自定义 404 页面或改写 Nginx 规则。
障碍二:内容散在十几个栏目里,没有梳理过
典型的文旅官网结构是:首页、景区介绍、票务、地图、交通、攻略、新闻、专题、展览、票务须知、客服、加盟合作……十几个栏目,每个栏目下面还有子页面。让 AI 从首页开始猜哪个页面有答案,成本很高。
障碍三:写无法验证的自称没有用
llms.txt 里的每一句都会进入模型的上下文。如果写的是无法验证的自称,AI 采纳度低,写可验证事实反而更有优势——比如具体开放时间、具体票务政策、可核实的联系方式。
障碍四:把 llms.txt 当成 SEO 替代品
这是最常见的误判。llms.txt 解决的是"AI 代理怎么找到你的核心页面",它不替代结构化数据、不替代页面正文质量,也不替代 sitemap 与 robots.txt。前面提到的两组实测数据已经说明:多数主流 AI 爬虫并不会主动去读这个文件。把 llms.txt 当成 SEO 替代品的团队,往往会在文件上线后两个月看不到任何变化,然后得出"没用"的结论并放弃——真正该做的是回头检查结构化数据与页面内容的可抽取性,而不是加大 llms.txt 的篇幅。
障碍五:以为放完就完事,忘了维护
llms.txt 是快照。网站改了栏目、加了页面、换了票务政策,文件不更新,AI 读到的就是过期说明书。维护成本比部署成本高。
四、问题本质:四个文件各管什么
| 文件 | 解决的问题 | 面向谁 | 谁来读 |
|---|---|---|---|
robots.txt |
让不让你抓 | 抓取规则 | 所有爬虫,含 AI 检索爬虫 |
sitemap.xml |
有哪些 URL | URL 清单 | 搜索引擎与部分 AI 爬虫 |
llms.txt |
这个站对 AI 的一句话说明书 | 内容索引与摘要 | AI 代理、第三方工具 |
llms-full.txt |
全文版上下文 | 完整正文 | 部分代理工具 |
llmstxt.org 的规范把文件结构规定得很清楚:根路径 /llms.txt(也可放在子路径),一个 H1 站名(规范中最核心的必需区块)、一段 > 开头的引用句摘要、零到多个不含标题的 Markdown 段落、再到零到多个以 H2 分隔的"文件列表"区段;另有约定俗成的 ## Optional 区段放次要链接[4]。
五、核心方法:把 llms.txt 当成内容盘点表
有效的做法不是"写一个漂亮的自述文件",而是借这次机会把网站结构梳理一遍:哪些页面是核心事实(票务、开放时间、交通)、哪些是攻略、哪些是新闻、哪些其实已经过时了。这个梳理顺带解决了 GEO 的另一个核心问题——AI 找不到关键页面。
具体拆成三件事来做。
动作一:给页面分级,把核心事实页挑出来
按"AI 引用价值"给栏目排个序:票务政策、开放时间、交通与门票预约、联系方式属于第一梯队,这类页面的内容一旦被 AI 引用就直接影响游客决策;游玩路线、住宿周边、季节性活动属于第二梯队,是决策补充;新闻公告、荣誉介绍、领导视察属于第三梯队,基本不承担引用价值。llms.txt 的链接清单优先放前两个梯队,第三梯队可以放到 ## Optional 区段里。
动作二:把散落的政策数字合并成一处
文旅网站最常见的结构性问题,是同一个事实散落在三处:票务须知页写"旺季 4 月 1 日至 10 月 31 日",景区介绍页写"夏季开放至 18:00",公众号推文写"暑期延时开放"。AI 抓到哪一条取决于它访问了哪个页面。合并成一处之后,llms.txt 里指向那一个页面,同时在页面上加 FAQPage 标记,机器抓到的答案就是一致的。事实一致比事实丰富更重要——矛盾的开放时间会让 AI 倾向于回避回答而不是给你一个错答案。
动作三:给每个链接写一句可核验的说明
llms.txt 里光有链接不够,每个链接后面补一句"这个页面解决什么问题"的短描述。描述要写事实("含各景区门票价格与优惠政策对照表"),不要写形容词("丰富全面的旅游资讯")。前面提到的实测规律在这里直接适用:写可验证事实,AI 采纳度高;写无法验证的自称,AI 采不采纳且不报错。
六、5 个立即可执行的动作
步骤 1:确认部署前提
llms.txt 必须放在站点根目录,能通过 你的域名/llms.txt 这个路径直接访问(HTTP 200、Content-Type 为 text/plain 或 text/markdown)。WordPress 站点如果根目录不能放静态文件,可以用 rewrite 规则把 /llms.txt 路由到一个动态输出函数——zhihuilvyou.com 就是这么实现的。
步骤 2:写文件头(站名 + 一句话简介)
首行是 H1 站名,紧跟一段以 > 开头的引用句,用 40-80 字说清"你是谁、服务谁、解决什么问题"。这句话是 AI 建立站点认知的锚点,不要写口号,要写事实。
步骤 3:分区列出核心内容与关键页面
用 H2 分区(核心业务 / 代表内容 / 定价 / 联系方式),每个重要页面写成 Markdown 链接并附一句说明。控制在 30 个链接以内,只放"你希望 AI 引用你时引用的那些页面"。
步骤 4:写清楚可验证的事实区
包括备案信息、公开联系方式、可核实的运营数据。避免无法验证的自称——AI 对不可验证声明的采纳度低,写可验证事实反而是引用率优势。
步骤 5:部署并持续维护
上传后用 curl 验证返回 200 与内容完整。每次网站新增重要内容板块时同步更新 llms.txt;建议文件内标注更新日期,配合 AI 爬虫日志观察 30 天内的抓取变化。
完整的文件骨架如下(可直接改写使用):
“`markdown
智慧旅游网
智慧旅游网(zhihuilvyou.com)是面向文旅行业的 AI 搜索可见性建设平台,提供景区、酒店、民宿、旅行社、邮轮、文创等场景的 GEO 诊断与结构化改造服务。
本站点的核心内容围绕"文旅行业如何被 AI 搜索引用"展开,所有数据均标注公开来源。
核心业务
- 景区 GEO 现状诊断:用真实游客问法实测豆包、DeepSeek、ChatGPT 等工具,输出引用率与事实错误清单。
- FAQPage Schema 部署教程:景区官网结构化数据部署的完整步骤与验证方法。
定价与联系方式
可验证事实
- 站点备案号与运营主体信息见页脚版权声明。
- 所有引用数据均标注原始来源机构与链接。
“`
七、CTA:先做一次内容盘点
在动手写 llms.txt 之前,先把网站栏目梳理一遍:哪些页面是核心事实、哪些是攻略、哪些其实已经过时。这份梳理顺带解决了 GEO 的另一个核心问题——AI 找不到关键页面。
FAQ(常见问题)
Q1: llms.txt 需要提交给 AI 厂商吗?
没有官方提交入口。它依赖 AI 爬虫主动访问根目录,或在抓取你的页面时按约定路径发现。保持 URL 规范(根目录、小写文件名)即可。
Q2: 文件多大合适?可以放全文内容吗?
轻量索引定位,建议 2-8KB。放目录和摘要而不是全文;全文引用效率靠页面本身的正文结构与 Schema。llmstxt.org 另有一个 llms-full.txt 的约定,用于提供全文版上下文[4]。
Q3: 和 robots.txt、sitemap.xml 冲突吗?
不冲突,三者分工不同:robots.txt 管"让不让你抓",sitemap.xml 管"有哪些 URL",llms.txt 管"这个站对 AI 的一句话说明书"。三个文件都维护好才是完整的 AI 可达性配置。
Q4: 多语种网站要每个语言放一份吗?
可以放 llms-zh.txt、llms-en.txt 分语言版本并在主文件中链接,或主文件双语混排。英文入境游市场(Perplexity/ChatGPT 场景)建议至少保证英文版内容可达。
Q5: WordPress 主机不允许放根目录文件,怎么部署 llms.txt?
用 rewrite 路由方案:在主题的 functions.php 里 add_rewrite_rule 把 llms.txt 请求路由到一个查询变量,再在模板钩子中判断该变量并输出文本内容(header 设为 text/plain)。zhihuilvyou.com 的 /llms.txt 就是这个方案的实例,无需在服务器根目录放置物理文件,且内容可以随数据库内容动态生成、保持更新。
Q6: 部署了 llms.txt 却没有 AI 抓取,正常吗?
正常,而且这是大多数站点的实际情况。Ahrefs 对 137,210 个域名的日志分析显示,28% 的站点发布了 llms.txt,但其中 97% 的文件在 2026 年 5 月没有收到任何访问[1]。所以判断依据应该是"文件本身写得好不好、路径对不对",而不是"有没有被抓"。真正值得观察的是服务器日志里 llms.txt 与 robots.txt 的抓取频次对比——如果 robots.txt 每天被抓几十次而 llms.txt 常年为零,说明当前主流 AI 爬虫确实不主动找这个文件,此时该把精力放回结构化数据与 robots.txt 策略上。
参考文献
[1] Ahrefs. https://ahrefs.com/blog/llmstxt-study
[2] EZY Research. https://www.ezy.ai/research/do-ai-bots-read-llms-txt
[3] Search Engine Journal. https://searchenginejournal.com/google-says-llms-txt-is-purely-speculative-for-now/577576
[4] llmstxt.org. https://llmstxt.org/
联系我们
智慧旅游网(zhihuilvyou.com)提供 llms.txt 编写、AI 可达性配置与 GEO 全案服务,本站 llms.txt 源文件结构可参考 https://www.zhihuilvyou.com/llms.txt。
| 服务模块 | 内容 |
|---|---|
| llms.txt 编写 | 按规范生成 H1 + 摘要 + 分区链接清单,控制在 30 个链接内 |
| AI 可达性配置 | robots.txt 分 UA 策略、sitemap.xml 校验、llms.txt 路由实现 |
| 抓取日志观测 | llms.txt 与 robots.txt 抓取频次对比,判断当前 AI 渠道的实际情况 |
联系方式:邮箱 1004344@qq.com(主题注明"llms.txt 部署");站点:https://www.zhihuilvyou.com
本文数据均标注公开来源。需要转载或引用本文数据的读者,可通过 1004344@qq.com 或上述邮箱联系。
本文系网络转载,转载目的在于传递更多信息,并不代表本网赞同其观点和对其真实性负责。如涉及作品内容、版权和其它问题,请在30日内与本网联系,我们将在第一时间删除内容!